テーブルフォーマットのファイル構造を比較する(Iceberg, Delta Lake, Hudi, Paimon)
テーブルフォーマットはファイルの集合をデータベースのように管理する技術です。
SnowflakeやDatabricksのような大規模ベンダーはもとより、AWSやGoogle Cloud、Trinoなど多くの製品でサポートされています。ただ、テーブルフォーマットといってもファイル構造は様々です。
この記事では、各テーブルフォーマットにおけるファイル構造と変化を比較します。
はじめに
テーブルフォーマットはデータレイクの欠点を補うために生まれた手法です。
フォーマットによって違いはあるものの、次の2種類のファイルが中心になっていることは共通しています。
オブジェクトストレージにメタデータ用のファイルを作成することで、トランザクションやタイムトラベルなど、便利な機能を実現しています。また、メタデータファイルの作成が各エンジンやクライアントに委ねられていることも共通しています。ただし、各フォーマットの実装や機能には大きな差があります。ファイル追加ひとつをとっても、挙動は全く違います。
これらの違いを理解するため、本記事ではテーブルフォーマットのファイル構造と変化を比較します。
※ この記事は、筆者が高速にメタデータを変更するファイルベースのDBを自作する一環で、4つのテーブルフォーマットのファイル構造を調査したものをまとめたものです。
比較対象
この記事では、よく知られている以下のフォーマットを比較します。
そして、それぞれのフォーマットに対して、次の観点で比較していきます。
- ファイル構造
- テーブルの状態の変更方法
- 競合の検知とトランザクションの実現方法
比較
Apache Iceberg
Apache Iceberg(以下、Iceberg)は、代表的なテーブルフォーマットの一つです。Netflixから生まれたフォーマットで、読み込みに強いのが特徴です。
※ この記事では最新であるVersion 3 の方法を紹介します。
ファイル構造
鳥瞰すると、Icebergは下図のように複数のレイヤーで構成されています。

図の中央の metadata layerは、名前の通りメタデータを持つレイヤーで、3種類のファイルで構成されています。また、Catalogがメタデータレイヤーの一番上にあるmetadata fileを参照していることもわかります。
各ファイルについて見ていきます。
metadata file
metadata fileはテーブル自身のメタデータが書かれているファイルです。
データ追加などでテーブルの状態が変更されるときに新しく作成され、カタログが指す先も変更されます。つまり、「metadata fileを作成し、カタログを更新する」という操作が、RDBでいうコミットに相当します。このファイルには、列やパーティションの情報をはじめ、後続のmanifest listへの参照などがjsonで書かれています。
例えば、以下のような中身です。
{
  "last-sequence-number": 3,
  "schemas": [
    {
      "type": "struct",
      "schema-id": 0,
      "fields": [
        {
          "id": 1,
          "name": "vendor_id",
          "required": false,
          "type": "long"
        },
        {
          "id": 2,
          "name": "trip_id",
          "required": false,
          "type": "long"
        },
        ...
      ]
    }
  ],
  "current-snapshot-id": 8502631251987096951,
  "snapshots": [
    {
      "sequence-number": 3,
      "snapshot-id": 8502631251987096951,
      "manifest-list": "s3://warehouse/nyc/taxis/metadata/snap-8502631251987096951-1-f77e86d0-0a2c-45ad-b30e-0d90ce8e68bd.avro",
      ...
    }
  ],
  ...
}
manifest list
manifest listはmanifest fileへの参照を列挙しているファイルで、前項のmetadata fileから参照されているファイルです。
中はAvroで書かれていて、各ファイルの情報が入っています。またパーティションの値も持っているので、クエリ実行時にどのmanifest fileを利用すべきかを判断することができるようになっています。
例えば、下のような値が入っています。(可視化のため、avroの中身をjsonに直しています)
[
  {
    "manifest_path": "s3://warehouse/nyc/taxis/metadata/f77e86d0-0a2c-45ad-b30e-0d90ce8e68bd-m1.avro",
    "manifest_length": 7486,
    "added_snapshot_id": 8502631251987096951,
    "added_files_count": 1,
    "added_rows_count": 1,
    "partitions": "[{\"lower_bound\": \"1", \"upper_bound\": \"2"}]",
    ...
  },
  {
    "manifest_path": "s3://warehouse/nyc/taxis/metadata/9e6d91da-fbfc-4c71-aa91-68ad62e27139-m0.avro",
    "manifest_length": 7563,
    "added_snapshot_id": 9069729192205494592,
    "added_files_count": 2,
    "deleted_files_count": 0,
    "added_rows_count": 4,
    "partitions": "[{\"lower_bound\": \"1", \"upper_bound\": \"1\"}]",
    ...
  },
  ...
]
manifest file
manifest fileにはファイルのパスや統計がAvroで入っています。
このファイルまで辿ってくるとデータファイルへのパスが手に入ります。
具体的には、以下のようになっています。(可視化のため、avroの中身をjsonに直しています)
[
  {
    "status": 1,
    "snapshot_id": 9069729192205494592,
    "data_file": "{\"content\": 0, \"file_path\": \"s3://warehouse/nyc/taxis/data/vendor_id=1/00000-4-c7fe0274-81c2-4022-9a1c-2859405b3967-0-00001.parquet\", ...",
    ...
  },
  {
    "status": 1,
    "snapshot_id": 9069729192205494592,
    "data_file": "{\"content\": 0, \"file_path\": \"s3://warehouse/nyc/taxis/data/vendor_id=2/00000-4-c7fe0274-81c2-4022-9a1c-2859405b3967-0-00002.parquet\"...",
    ...
  }
]
data_fileフィールドの中にjsonが入っているのが見えますが、ここにはファイル情報が入っています。data_fileフィールドのjsonには以下のような情報が入っています。
{
  "data_file": {
    "content": 0,
    "file_path": "s3://warehouse/nyc/taxis/data/vendor_id=1/00000-4-c7fe0274-81c2-4022-9a1c-2859405b3967-0-00001.parquet",
    "file_format": "PARQUET",
    "partition": {
      "vendor_id": 1
    },
    "record_count": 2,
    "file_size_in_bytes": 1605,
    "column_sizes": [
      {
        "key": 1,
        "value": 76
      },
    ],
    "lower_bounds": [
      {
        "key": 1,
        "value": "1"
      },
    ],
    "upper_bounds": [
      {
        "key": 1,
        "value": "2"
      },
    ],
    ...
  }
}
ファイル名や、フォーマット(parquet)、列の上限(lower_bounds)下限(upper_bounds)などが入っていることがわかります。
data file
data fileは実際のデータを持ったファイルです。
ファイル形式さえ気をつければ、既存のファイルをそのまま利用することができます。通常のデータレイクに置くファイルと変わりません。
ファイル構造まとめ
以上のように、Icebergは3種類のメタデータからできています。それ以外に統計情報用のファイルが作られることもありますが、
metadata file -> manifest list -> manifest file -> data file
という関係がIcebergの根幹です。
テーブルの状態の変更方法
ファイルの関係がわかればテーブルの状態を変更する方法は直感的で、ファイルを順番に作成していくだけです。つまり、
data fileを作る- 作成した
data fileの情報を書いたmanifest fileを作る - 作成した
manifest fileの情報を書いたmanifest listを作る - 作成した
manifest listの情報を書いたmetadata fileを作る - 作成した
metadata fileに向けてカタログの参照先を変更する
という順番でファイルを作っていけばテーブルの状態を変えることができます。
競合の検知とトランザクションの実現方法
ここまでで、ファイルを順番に作成していけばいいことがわかりました。
では、複数のプロセスが同時に変更しようとしている場合はどのように競合を防ぐのでしょうか?
答えは簡単で、「1つしか成功しない」です。
Icebergは、最初に現行のバージョンを取得し、そのバージョンに対応するメタデータを使ってテーブルの状態を変更します。そのため、変更中に現行バージョンが変わった場合、メタデータの変更をやり直します。つまり、「楽観的(optimistic)」です。
リトライが頻発した場合負荷が大きくなる設計ではありますが、大量のファイルを扱うための設計上の工夫です。公式には以下のように書かれています。
(the Iceberg table format) is designed to manage a large, slow-changing collection of files in a distributed file system or key-value store as a table.
訳: (Icebergは)分散ファイルシステムやKVS上にある、大規模な、更新頻度が低いファイルの集合をテーブルとして管理するために設計されている。
以上、Icebergのファイルの利用方法を紹介しました。
Delta Lake
Delta Lakeは、Databricksが作成したフォーマットで、1種類のメタデータファイルでも動作するシンプルさを持っています。
機能追加が進んでいるため全ての機能をサポートするには多くの実装が必要ですが、ファイルの追加・削除だけを対象にすると非常にシンプルにできています。
※ この記事は最新であるReader Version 3, Writer version 7 までの機能が記載されたDelta Transaction Log Protocolを参照しています。
ファイル構造
Delta Lakeでは、最もシンプルな場合、ファイル構造は下のようになります。
.
└── simple-table
    ├── _delta_log
    │   ├── 00000000000000000000.json
    │   ├── 0000000000000000001.checkpoint.parquet
    │   ├── _last_checkpoint
    │   ...
    ├── part-00000-29aaca97-e41b-4dd5-b94c-6d80e6eec67a-c000.snappy.parquet
    ├── part-00000-918a423a-82bb-4430-88b3-3c93c4dd8479-c000.snappy.parquet
    ...
ルートの階層にあるファイル(part-00000-918a423a-82bb-4430-88b3-3c93c4dd8479-c000.snappy.parquetなど)が実際のデータが入っているファイル(Data File)で、_delta_logディレクトリの中に入っているファイルがメタデータです。
さらに、パーティションやCDC対応などの機能を使用すると、下のように複数のディレクトリが作成されます。
.
└── complex-table
    ├── _change_data
    │   ├── group=Bar
    │   │   ├── cdc-00000-c483b69f-c1c0-4581-b254-35cb27c59d01.c000.snappy.parquet
    │   ├── group=Foo
    │   │   ├── cdc-00000-67bca4a4-160f-4ee8-beb4-32db77bbed06.c000.snappy.parquet
    │   ...
    ├── _delta_log
    │   ├── _sidecars
    │   │   └── 00000000000000000010.checkpoint.0000000001.0000000001.5f45d5fc-9e91-4033-bffb-05430eb673cf.parquet
    │   ├── 00000000000000000000.crc
    │   ├── 00000000000000000000.json
    │   ├── 00000000000000000010.checkpoint.38064ff7-86d5-4b66-8bdf-159f13fd9e95.json
    │   ├── _last_checkpoint
    │   ...
    ├── group=Bar
    │   ├── part-00000-5ec3b332-a58e-466c-b2a2-3efb8cbb91e4.c000.snappy.parquet
    ├── group=Foo
    │   ├── part-00000-0d369fcb-47d7-4704-9c51-f1959825ba25.c000.snappy.parquet
    ...
パーティション(group)ごとにディレクトリが分けられているのがわかります。
Delta File
Delta Fileはテーブル変更の履歴が入っているメタデータファイルで、テーブルを変更すると作成されます。
テーブルを読み込むときはDelta Fileを順番に読んでいけば現在のテーブルの状態がわかるようになっています。
ファイルはJSON(正確にはJSON Lines)で、下のような内容が書かれています。
{
  "metaData": {
    "id": "d853860f-c0f1-4592-848a-f7145eb9082f",
    "format": {
      "provider": "parquet",
      "options": {}
    },
    "schemaString": "{\"type\":\"struct\",\"fields\":[{\"name\":\"id\",\"type\":\"integer\",\"nullable\":true,\"metadata\":{}},...",
    "partitionColumns": [
      "group"
    ],
    "configuration": {
      "delta.enableRowTracking": "true",
      ...
    },
    ...
  }
}
{
  "protocol": {
    "minReaderVersion": 3,
    "minWriterVersion": 7,
    "readerFeatures": [...],
    "writerFeatures": [...]
  }
}
{
  "add": {
    "path": "group=Bar/part-00000-a7d76845-a25a-417f-a7db-f52be86f027f.c000.snappy.parquet",
    "size": 1024,
    ...
  }
}
{
  "remove": {
    "path": "group=Foo/part-00000-40f9fb17-d0c7-484b-84a6-a30c37e187b5.c000.snappy.parquet",
    ...
  }
}
{
  "cdc":{
    "path":"_change_data/group=Bar/cdc-00000-ef0f9fbe-36e1-4850-8a36-c66a37b365ae.c000.snappy.parquet",
    ...
  }
}
...
各jsonのキー(addやremove)が操作を表しています。この例では、「テーブル定義(metadata)」、「プロトコル設定(protocol)」、「ファイル追加(add)」、「ファイル削除(remove)」、「データ変更(cdc)」の操作をしたことが書かれています。
また、不正な変更を検知するためにチェックサム用のファイルを作ることもできます。
Checkpoint
Delta Fileはテーブルに変更があるたびに作成されるので、ファイル数はどんどん増えていきます。このDelta Fileの内容をまとめたものがCheckpointです。
Checkpointには対象のDelta Fileまでの有効な変更が全て入っているため、「テーブルの状態を把握するためには最新のCheckpointとその先のDelta Fileを読めばよい」ようになっています。
Checkpointは下の3種類のファイルの組み合わせで出来ています。
Delta Fileの内容をまとめたSidecar FileSidecar Fileのパスを持つCheckpoint File- 最新の
Checkpoint Fileのファイルのパスを持つLast Checkpoint File
この3種類のファイルを順にたどれば最新のCheckpointの情報を取得できるわけです。
まず、Sidecar Fileについて。parquetで書かれていて、中身は下のようにデータファイルに関する情報が入っています (可視化のため、parquetの中身をjsonに直しています)
[
  {
    "path": "group=Bar/part-00000-a7d76845-a25a-417f-a7db-f52be86f027f.c000.snappy.parquet",
    "deletionTimestamp": 1768734735552,
    ...
  },
  {
    "path": "group=Foo/part-00000-3436b65d-4fd4-4646-b4d5-e8a522b23c4a.c000.snappy.parquet",
    "deletionTimestamp": null,
    ...
  },
  ...
]
そして、Checkpoint Fileには下のようにSidecar Fileのパスやテーブルの情報がjsonで入っています。
{
  "checkpointMetadata": {
    "version": 10
  }
}
{
  "sidecar": {
    "path": "00000000000000000010.checkpoint.0000000001.0000000001.5f45d5fc-9e91-4033-bffb-05430eb673cf.parquet",
    "sizeInBytes": 12667,
  }
}
{
  "protocol": {
    "minReaderVersion": 3,
    "minWriterVersion": 7,
    "readerFeatures": [...],
    "writerFeatures": [...],
  }
}
{
  "metaData": {
    "id": "d853860f-c0f1-4592-848a-f7145eb9082f",
    "format": {
      "provider": "parquet",
      "options": {}
    },
    "schemaString": "{\"type\":\"struct\",\"fields\":[{\"name\":\"id\",\"type\":\"integer\",\"nullable\":true,\"metadata\":{}},...",
    "partitionColumns": [
      "group"
    ],
    ...
  }
}
...
そして、Last Checkpoint Fileはファイル名が固定(_last_checkpoint)されていて、下のようにCheckpoint Fileへのパスなどがjsonで入っています。
{
  "version": 10,
  "sizeInBytes": 14079,
  "v2Checkpoint": {
    "path": "00000000000000000010.checkpoint.38064ff7-86d5-4b66-8bdf-159f13fd9e95.json",
    "sizeInBytes": 1412,
    "nonFileActions": [...],
    "sidecarFiles": [
      {
        "path": "00000000000000000010.checkpoint.0000000001.0000000001.5f45d5fc-9e91-4033-bffb-05430eb673cf.parquet",
        "sizeInBytes": 12667,
        ...
      }
    ]
  },
  ...
}
Change Data File
ファイルの変更内容を書いているものが、Change Data Fileです。
UPDATEやDELETEなどデータを変えたときに作られます。Delta Fileに書かれているcdc操作に書かれたパスのファイルを読むことで、データの変更を追っているプログラムが既存の値を覚えずに変更内容を把握することができます。
ファイルはparquetで書かれていて、下のような内容です。(可視化のため、parquetの中身をjsonに直しています)
[
  {
    "id": 2,
    "value": "bravo",
    "_row-id-col-xxx": 0,
    "_change_type": "delete",
    ...
  }
]
ファイル構造まとめ
以上、代表的なファイルを紹介しました。Delta Fileを中心にメタデータが構成されていることがわかります。そして、Delta Fileを読み取る時のファイルの順番は大まかに下のようになります。
Last Checkpoint File -> Checkpoint -> Delta Files -> 実際のファイル
他にもコンパクションや削除ベクトル(Deletion Vector)用のファイルがありますが、Delta Fileがメタデータの中心であることは変わりません。
テーブルの状態の変更方法
前節でDelta Lakeには複数のメタデータ用ファイルがあることを紹介しました。
複数の種類があるものの、各ファイルはDelta Fileを中心としているため、テーブルを変えるときは、下のように実ファイルを作成した後にDelta Fileを作成するだけで十分です。
- 実ファイルを作成
Delta Fileを作成- (必要であれば)
Checkpointを作成
競合の検知とトランザクションの実現方法
Delta Lakeは、メタデータの変更が非常に単純です。このシンプルさを支えるのが「Delta Fileを書く = コミット」という関係です。この関係を支えるため、ファイル名をインクリメントし続ける必要があります。つまり、最初のDelta Fileは00000000000000000000.jsonで、次のコミットは00000000000000000001.jsonと名前が決まっています。これに加えて上書きを禁止しているので、同時に書き込もうとしている場合は1プロセスしか成功せず、残りのプロセスはリトライすることになります。
以上、Delta Lakeのファイルの利用方法を紹介しました。
Apache Hudi
Apache Hudi(以下、Hudi)はUber発のフォーマットで、多くの機能を持っています。
コンパクションやインデックスなど、「インクリメンタルな書き込みを高速にしつつ、読み込みも速くする」ための機能を多く内包しているのが特徴です。機能の多さを考えると、「データレイクを便利にする仕組み」と捉えるよりも「(ファイルベースの)データベース管理システム」と捉えた方が役割を想像しやすいでしょう。IcebergやDelta Lakeよりもカバーしている機能範囲が大きく、テーブルフォーマットに相当する仕様を含んだ、より広範な仕様です。
データを追加するとき、Hudiはインデックスや統計情報を作成しつつデータ用のファイルも作ります。また、テーブルサービスと呼ばれる、データを管理するための機能も持っています。例えば、コンパクションやクラスタリング、不要データの削除を行う機能があり、非同期で呼び出すことができます。
この記事では、Hudiの豊富な機能を支える、メタデータを中心に取り上げます。

※ この記事では最新のバージョンである1.1.1 の方法を紹介します。
ファイル構造
Hudiのファイルは、.hoodieディレクトリにまとめられた複数種類のメタデータファイルと、実際のデータを持つFile Groupで構成されています。またメタデータファイルには、他のテーブルフォーマットに相当する機能を実現するものと、より高度な機能のためのものがあります。
例えば、テーブルフォーマット部分は下図のようなファイルが用意されています。
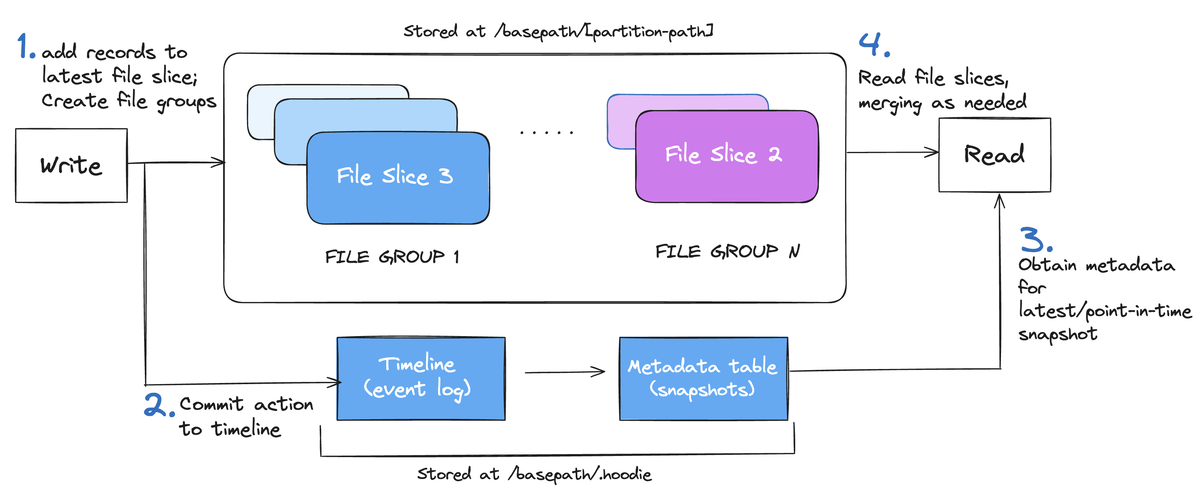
この図に書かれている「Timeline」と「Metadata Table」部分がメタデータで、「File Group / File Slice」に実際のデータが入っています。ただし、実際のデータ用のファイルであっても、これまでのフォーマットとは違いユーザーが作ったファイルが入っているわけではありません。
この節ではHudiがどのようなファイルを作っているか見ていきます。
Timeline
テーブルの変更を記録しているのがTimelineで、「操作内容」と「時間」をAvroで記録しています。
Timelineの操作には複数の状態(requested、inflight、completed)があり、状態遷移のタイミングで状態に応じたファイル(xxx.requested、xxx.inflight)を作成することで作業の進行状態と完了順序がわかるようになっています。また、ファイルが溜まると、./hoodie/timeline/historyディレクトリにまとめられます。さらにLSMツリーの要領で、もっと溜まれば次のレベルにまとめられます。
例えば、completed状態のファイルは以下のようになっています。(可視化のため、parquetの中身をjsonに直しています)
{
  "partitionToWriteStats": {
    "partitionA": [
      {
        "fileId": "2786c86a-9adf-48e5-9298-43ad235655f8-0",
        "path": "partitionA/2786c86a-9adf-48e5-9298-43ad235655f8-0_0-418-6254_20260125031732773.parquet",
        "prevCommit": "20260125031728591",
        "numWrites": 6,
        "partitionPath": "partitionA",
        "fileSizeInBytes": 436502,
        ...
      }
    ]
  },
  "operationType": "UPSERT",
  ...
}
この例では、"partitionA"というパーティションにUPSERTされたことが書かれています。
更に、Timelineをまとめた場合、manifestというファイルから参照できるようになっています。manifestファイルの中には以下のようにTimelineをまとめたファイルのパスが書かれています。(JSON)
{
  "files" : [
    {
      "fileName" : "20260125031656516_20260125031708044_0.parquet",
      "fileLen" : 3298
    },
    {
      "fileName" : "20260125031710285_20260125031710726_0.parquet",
      "fileLen" : 11560
    },
    ...
  ]
}
まとめると、Timelineのファイルは下のようになっています。
path/.hoodie/timeline/
├── 20260125031732773.commit.requested  <- 操作開始
├── 20260125031732773.inflight <- 操作中
├── 20260125031732773_20260125031736753.commit <- 操作完了
├── ...
└── history
    ├── 20260125031656516_20260125031708044_0.parquet <- まとめられたファイル
    ├── manifest_4 <- manifestファイル
    ├── ...
    └── _version_ <- 最新のmanifestの番号を持つファイル
なお、「時間を記録する」と軽く書いていますが、複数の書き込みに対応するために「過去のTimelineよりも後の時間でファイルを作成すること」が仕様で明記されているので実装には慎重さが必要です。
File Group / File Slice
File GroupとFile Sliceは実際のデータが入っているファイルです。
IcebergやDelta Lakeの場合はユーザーが作ったファイルをそのまま置くことができますが、Hudiの場合はデータ用のファイルのフォーマットも決まっていて、File GroupとFile Sliceに沿ってファイルを作る必要があります。
まず、File Sliceは特定バージョン時点でのデータを取得できる単位で、Base FileとLog Fileで出来ています。ほとんどのデータはBase Fileに入っていて、追加データがLog Fileとして追加されます。つまり、Base FileとLog Fileをマージすると、そのバージョンの完全な内容になります。そして、複数バージョンをまとめた単位がFile Groupです。
たとえば、uuid列とfare列を持つテーブルに対するBase Fileは、以下のようにHudi用のデータとユーザーが指定した値(uuidやfare列)が混ざって入っています。(可視化のため、parquetの中身をjsonに直しています)
[
  {
    "_hoodie_commit_time": 20260125153512834,
    "_hoodie_partition_path": "partitionA",
    "uuid": "334e26e9-8355-45cc-97c6-c31daf0df330",
    "fare": 19.1,
    ...
  },
  ...
]
そして、追加データをもつLog Fileは、下のようにBase Fileと同じような内容が入っています(Hudiの独自フォーマットなので、可視化のためjsonに直しています)
{
  "log_block_length": 2278,
  "version": 1,
  "content_length": 1388,
  "content": [
    {
      "_hoodie_commit_time": "20260125153542168",
      "_hoodie_partition_path": "partitionA",
      "uuid": "e96c4396-3fad-413a-a942-4cb36106d721",
      "fare": 30.7,
      ...
    },
    ...
  ]
}
Metadata Table
Metadata Tableは高速化のために作られたメタデータの集まりです。
具体的には、ファイル一覧の情報と、統計情報を持つファイル群です。
まず、ファイルの一覧を保持しているファイルは.hoodie/metadata/filesディレクトリの中にあり、以下のような内容です。(Hudiの独自フォーマットなので、可視化のためjsonに直しています)
{
  "__all_partitions__": {
    "_hoodie_file_name": {
      "string": "files-0000-0_10-190-2875_20260126133912332.hfile"
    },
    "filesystemMetadata": {
      "map": {
        "partitionC": {...},
        "partitionB": {...},
        "partitionA": {...}
      }
    },
    ...
  },
  "partitionA": {
    "filesystemMetadata": {
      "map": {
        "2fa1b4ab-c3cf-46d1-af1e-bf796d3619fa-0_0-143-1990_20260126133906789.parquet": {
          "size": 436462,
          "isDeleted": false
        },
        "2fa1b4ab-c3cf-46d1-af1e-bf796d3619fa-0_0-111-1375_20260126133903922.parquet": {
          "size": 436435,
          "isDeleted": false
        },
        ...
      }
    },
    ...
  },
  "partitionB": {
    "filesystemMetadata": {
      "map": {
        "e81b01ad-ecdd-4b54-b6d7-2436af4c0f61-0_0-175-2605_20260126133909478.parquet": {
          "size": 436192,
          "isDeleted": false
        },
        "e81b01ad-ecdd-4b54-b6d7-2436af4c0f61-0_1-39-301_20260126133851419.parquet": {
          "size": 436140,
          "isDeleted": false
        },
        ...
      }
    },
  },
}
__all_partitions__ が各パーティションの情報を持ち、それぞれのパーティションの中に具体的なファイル情報が書かれているのがわかります。
また、統計情報は列単位とパーティション単位でディレクトリが分けられています(.hoodie/metadata/column_statsと.hoodie/metadata/partition_stats)。例えば、uuid列の統計情報は下のよう書かれています。(Hudiの独自フォーマットなので、可視化のためjsonに直しています)
{
  "columnName": "uuid",
  "fileName": "2fa1b4ab-c3cf-46d1-af1e-bf796d3619fa-0_0-143-1990_20260126133906789.parquet",
  "minValue": "134e26e9-8355-45cc-97c6-c31daf0df330",
  "maxValue": "e96c4396-3fad-413a-a942-4cb36106d721",
  "valueCount": 6,
  "nullCount": 0,
  "totalSize": 150,
  ...
}
{
  "fileName": "211656c3-27f9-4fe5-820d-bb26f951ec2e-0_0-39-300_20260126133851419.parquet",
  "columnName": "uuid",
  "minValue": "c8abbe79-8d89-47ea-b4ce-4d224bae5bfa",
  "maxValue": "c8abbe79-8d89-47ea-b4ce-4d224bae5bfa",
  "valueCount": 1,
  "nullCount": 0,
  "totalSize": 88,
  ...
}
インデックス
高速に行を特定するためのインデックス用ファイルも用意されています。行の変更を反映し続けるCDCを使用している場合、特に有効です。
Hudiのインデックスには以下の種類が用意されています。
- Bloomfilter
- Record Index(プライマリキーのようなもの)
- 式インデックス
- セカンダリインデックス
どれも名前のとおりで、例えばRecord Indexの中には下のようにキー(例ではuuid)ごとにパーティションの場所が書かれています(Hudiの独自フォーマットなので、可視化のためjsonに直しています)
{
  "13cf430c-889d-4015-bc98-59bdce1e530c": {
    "partitionName": "partitionB",
    "instantTime": 1769434749478,
    ...
  },
  "c8abbe79-8d89-47ea-b4ce-4d224bae5bfa": {
    "partitionName": "partitionC",
    "instantTime": 1769434731419,
    ...
  },
  ...
}
ファイル構造まとめ
以上、Hudiの持つ主要なファイルを紹介しました。これ以外にもHudiは様々なファイルを持っていますが、長くなるためここまでにします。
テーブルの状態の変更方法
前節で紹介したように、Hudiは様々なファイルがあります。
更新は次の手順で行われます。
Timelineにファイルを作成- データファイル作成 (インデックスを参照しつつ適切なFile Groupを選択し、作成する)
- メタデータとインデックスを更新
Timelineにcompleted状態のファイルを作成- (必要であれば)テーブルサービスを実行
テーブルサービスは毎回実行する必要はありません。また、非同期で実行することもできます。
競合の検知とトランザクションの実現方法
Hudiのデータ変更は同時書き込み対策のためにTimelineの時間を使用します。また、DynamoDBなどで分散ロックを取る方法も提供されています。
ただし、OCCであるためリトライには負担があります。そのため、早期に衝突を検知する方法として、Early Conflict DetectionやNon-blocking Concurrency Controlの実装が試みられているのも特徴的です
以上、Hudiのファイルの利用方法を紹介しました。
Apache Paimon
Apache Paimon(以下、Paimon)は、Flinkコミュニティ発のフォーマットで、ストリーミングを重視したフォーマットです。
大まかな構造はIcebergと似ているものの、データファイルの作成方法まで決まっている点が大きく違います。例えば、プライマリーキーを考慮したファイルを作成することや、コンパクションの対象範囲が規定されています。データファイルの仕様まで定義することで機能を増やしている点はHudiに似ていて、仕様の広さはIcebergとHudiの中間的な位置にあります。
※ この記事は最新バージョンである1.3 の方法を紹介します。
ファイル構造
Paimonのファイルは、下図のようにSnapshot,Manifest,Data,Schemaディレクトリにわかれています。
ManifestはIcebergのMetadataレイヤーに相当し、SnapshotとSchemaがカタログ相当の役割を持ちます。また、Dataディレクトリにはデータファイルと共にCDCに便利なChangelogと呼ばれるファイルも入ります。

それぞれについて詳しく見ていきます。
Manifest
Manifestは、データファイルの一覧を持っているData Manifestと、そのファイルのポインタとなっているManifest Listで構成されています。
Data Manifestは以下のようにDataファイルの情報を持っています。(可視化のため、avroの中身をjsonに直しています)
[
  {
    "_PARTITION": "partitionA",
    "_FILE": {
      "_FILE_NAME": "changelog-d10eaede-a8eb-4fc9-b338-b91e7b86c083-0.parquet",
      "_FILE_SIZE": 2588,
      "_ROW_COUNT": 1,
      "_MIN_KEY": "196c4396-3fad-413a-a942-4cb36106d721",
      "_MAX_KEY": "196c4396-3fad-413a-a942-4cb36106d721",
      ...
    },
    ...
  },
  {
    "_PARTITION": "partitionC",
    "_FILE": {
      "_FILE_NAME": "changelog-acd08255-0cfe-4980-91c3-6bd3db6472e9-0.parquet",
      "_FILE_SIZE": 2580,
      "_ROW_COUNT": 2,
      "_MIN_KEY": "134e26e9-8355-45cc-97c6-c31daf0df330",
      "_MAX_KEY": "296c4396-3fad-413a-a942-4cb36106d721",
      ...
    },
    ...
  },
  ...
]
そして、Manifest Listは以下のようにData Manifestを指す情報を持っています。
[
  {
    "_FILE_NAME": "manifest-afabf49f-d001-44f0-8162-bf0c5005408a-0",
    "_FILE_SIZE": 2329,
    "_PARTITION_STATS": {
      "_MIN_VALUES": "partitionA",
      "_MAX_VALUES": "partitionC",
      ...
    },
    ...
  }
  {
    "_FILE_NAME": "manifest-2cdf0d3f-4f2a-4c7f-9aff-13142bdcc35a-0",
    "_FILE_SIZE": 2438,
    "_PARTITION_STATS": {
      "_MIN_VALUES": "partitionA",
      "_MAX_VALUES": "partitionC",
      ...
    },
    ...
  },
  ...
]
Snapshot
現在のテーブルの状態を持っているのがSnapshotです。
Snapshotのファイルを作成することで、Paimonのテーブルにコミットしたことになります。ファイル名はsnapshot-1, snapshot-2のように連番になっていて、最大の番号を持っているものが最新のファイルです。
具体的には、以下のような情報をjsonで持っています。
{
  "id" : 5,
  "schemaId" : 0,
  "baseManifestList" : "manifest-list-531c89a4-c44e-4dc3-b211-a43add15324e-0",
  "baseManifestListSize" : 1108,
  "deltaManifestList" : "manifest-list-531c89a4-c44e-4dc3-b211-a43add15324e-1",
  "deltaManifestListSize" : 1010,
  "commitIdentifier" : 9223372036854775807,
  "commitKind" : "APPEND",
  ...
}
特徴的なのは、前回コミット時点の情報を持つbaseManifestListと対象コミットでの変更内容を持つdeltaManifestListの2つのManifest Listのファイル情報があることです。Paimonはこの2つのファイルを組み合わせることでテーブルの状態を把握できるようになっています。
Schema
Schemaはテーブルのスキーマを持っているファイルで、直感的な内容です。
具体的には、以下のような情報をjsonで持っています。
{
  "version": 3,
  "id": 0,
  "fields": [
    {
      "id": 0,
      "name": "ts",
      "type": "BIGINT"
    },
    {
      "id": 1,
      "name": "uuid",
      "type": "STRING NOT NULL"
    },
    ...
  ],
  "partitionKeys": ["partition"],
  "primaryKeys": ["uuid", "partition"],
  "options": {
    "bucket": "3",
    ...
  },
  ...
}
DataFile
Hudiと同じように、Paimonは実データをどのような内容を書くかも決まっています。
テーブルの内容はパーティションごとのディレクトリと、更に細分化するためのBucketディレクトリの下に保存されます(例: partition=partitionA/bucket-0/xxx.parquet)。さらに、PKを決めている場合は、Sorted Runという単位で順次保存されます。Sorted RunはLSMツリーの考え方をしていて、「まずレベル0としてファイルを作り、時期が来たら集約してレベルを上げる」という動きをします。また、下図のようにファイル内はキーで整列されているのも特徴です。
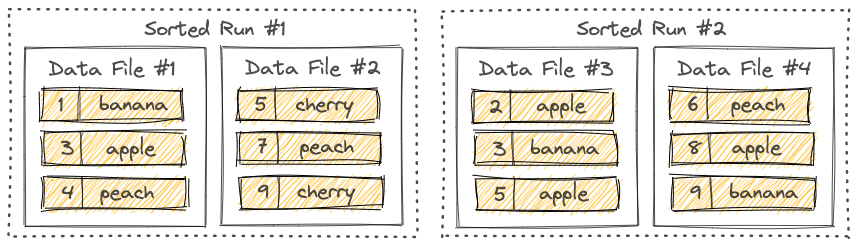
ファイルの内容は以下のようになっています。(parquetで作られますが、可視化のためjsonに直しています)
[
  {
    "_KEY_uuid": "134e26e9-8355-45cc-97c6-c31daf0df330",
    "_SEQUENCE_NUMBER": 1,
    "ts": 978480120000,
    "uuid": "134e26e9-8355-45cc-97c6-c31daf0df330",
    ...
  },
  {
    "_KEY_uuid": "296c4396-3fad-413a-a942-4cb36106d721",
    "_SEQUENCE_NUMBER": 2,
    "ts": 978483600000,
    "uuid": "296c4396-3fad-413a-a942-4cb36106d721",
    ...
  },
  ...
]
また、Changelogという、コミットの差分部分だけを持つファイルもあります。(フィールドは同じです。)
ファイルまとめ
以上、Paimonの主要なファイルを紹介しました。
テーブルの状態の変更方法
Paimonの状態変更のためには、前節で紹介したファイルを追加していき、最後にSnapshotを書き込むことでコミットが確定しテーブルの内容が変わります。
競合の検知とトランザクションの実現方法
書き込みが並行で走っている場合、Snapshotの存在チェックを衝突検知に利用できます。Snapshotが連番で作成されているためです。ただし、衝突を検知するため、ファイル作成時に同名ファイルがあったら上書きしないようにする仕組みは必要です。
以上、Paimonのファイルの利用方法を紹介しました。
まとめ
以上、Iceberg、 Delta Lake、 Hudi、 Paimonのファイル構造と仕組みを紹介しました。
フォーマット比較の参考になれば幸いです。
付録
この記事を作成するため、以下のページをよく参照しました。
- Iceberg
- Delta Lake
- Hudi
- Paimon
また、衝突の話については「The ultimate guide to table format internals - all my writing so far」という記事が詳しく、参考になります。
オブザーバビリティ成熟度の頂点とその先
この記事はMackerel Advent Calendar 2024の23日目の記事です
はじめに
世の中には多くのオブザーバビリティ製品が存在しています。
オブザーバビリティ(可観測性)の重要性を、多くの会社が訴えています。
Mackerel Advent Calendar 2024にもオブザーバビリティ向上に貢献する話が多く書かれています。
筆者がWebアプリケーションエンジニアとして所属しているMackerelも同様です。
そんな中、オブザーバビリティの活用度を測る指標として、「オブザーバビリティ成熟度」という言葉を使うことがあります。
New RelicやAWS、Grafanaなど、色々な会社が独自に定義していますが、おおまかに「データを収集している->活用できている->進歩的な手法が実践できている」と進んでいくのは共通しています。
では、それらが出来ていればオブザーバビリティを完全に活用できていると言えるのでしょうか。
オブザーバビリティ成熟度の最高点より先には何があるのでしょうか。
この記事は、オブザーバビリティを高めた先に開けてくる、オブザーバビリティを応用した、未来の当たり前をのぞき見する記事です。
オブザーバビリティ成熟度の先
オブザーバビリティがあり、システムの状態を把握できるようになった世界で、品質を更に向上させるために、人類は機械に何を期待するでしょうか。
オブザーバビリティ成熟度が最高になったとき、より良くするために何ができればよいでしょうか。
機械に期待する能力を大別すると、下のように分けられるでしょう。
- 平常時に期待する能力
- 異常時に期待する能力
- 異常を解決した後に期待する能力
- 能力を向上させるための能力
それぞれについて例と一緒に見ていきましょう。
※ 紹介する論文やWebページは理解を手助けするためのものであり、妥当性や実現可能性、評価を検証していないことに注意してください。
平常時に期待する能力
まずは、平常時に期待する能力について。
異常を予測する能力
異常が起きそうだとわかれば、異常が発生する前に対処することができます。
リソースが足りなくなる兆候を見つけられればリソースを追加することができますし、ハードウェアの劣化を予測できれば故障前に取り替えることができます。
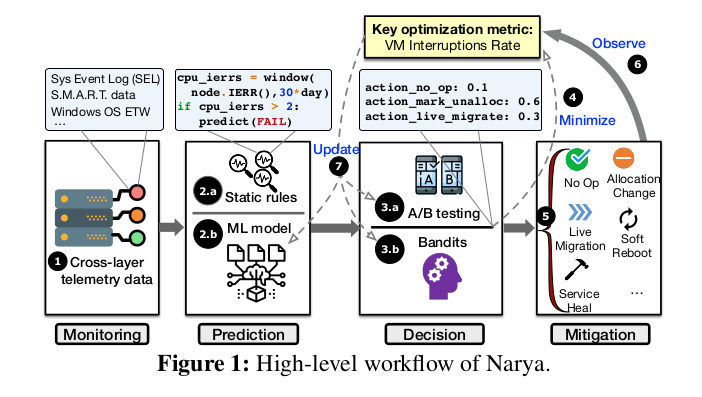
マイクロソフトは、そんな予測に挑戦しています。
「Predictive and Adaptive Failure Mitigation to Avert Production Cloud VM Interruptions」によると、ノードの劣化を検知してVMを別ノードへ移動しているそうです。
リソース最適化する能力
リソースを自動で調整することができれば、インフラコストを削減したり、消費電力を抑えることで環境に貢献する、など出来ます。
CPU利用率などの閾値を事前に設定することで使用量を調整することが一般的ですが、システムが複雑になるほど最適解を決めることが難しくなります。
機械に代替させたい能力です。
たとえば、esDNNのように将来のリソース量を予測することができれば自動でスケーリングをすることができるでしょう(esDNN: Deep Neural Network Based Multivariate Workload Prediction in Cloud Computing Environments)
異常を検知する能力
オブザーバビリティの先に期待する能力として、異常検知は特に人気のある能力です。
異常を早く見つけることができれば、システムに異常がある期間を短縮できます。
異常検知は長い歴史があり、多くの実装が存在しています。
例えば、GrafanaはPrometheusで異常検知を行うライブラリを提供しています。
しかし、異常検知は未だに利用しづらい分野でもあります。
たとえば、「How Industry Tackles Anomalies during Runtime: Approaches and Key Monitoring Parameters」には、シンプルなルールベースの異常検知が好まれている理由として、「計算コストが低い」「ドメイン知識を入力しやすい」などが挙げられています。
このような課題を乗り越えることが必要です。
異常時に期待する能力
前章は平常時に期待する能力を見てきました。
異常が起きた時にも活用したいですね。
異常の原因を発見する能力
異常の原因を発見することは、RCA(根本原因分析)とも呼ばれ、異常に関する問題としては花形です。
しかし、原因と一口に言っても特定する対象は多くあります。
異常のあるサービスを特定することが目的だったり、異常なノードの発見を目的にしたり。
他にも、URLやデプロイ、パラメータ、コードなど、原因と言えそうなものは何でも対象になります。
たとえばMeta(Facebook)は、アプリで実行した操作などからクラッシュ原因を特定しようとしています(Scalable Statistical Root Cause Analysis on App Telemetry)

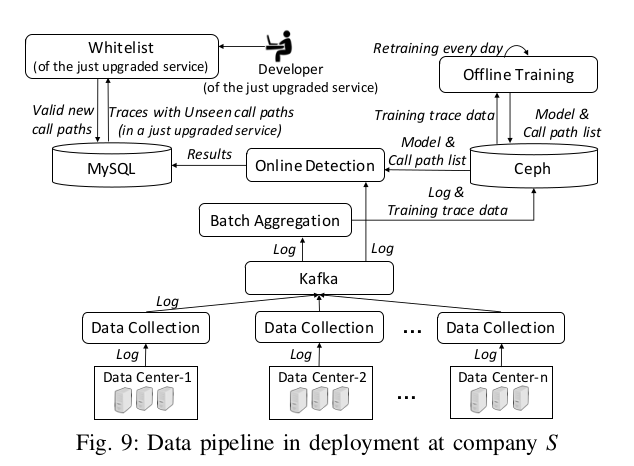
また、「Unsupervised Detection of Microservice Trace Anomalies through Service-Level Deep Bayesian Networks」では、正常なトレースを基にサービス間のコールグラフを事前に学習した後、正常時との乖離をリアルタイムに分析することで異常の原因を特定しています。
異常を解決してくれる能力
異常の原因を発見するだけでなく、治す能力にも期待したいところです。
ノードに問題が起きている場合に再起動したり、デプロイに問題がありそうならロールバックするなど、異常を自動で解決してくれると助かります。
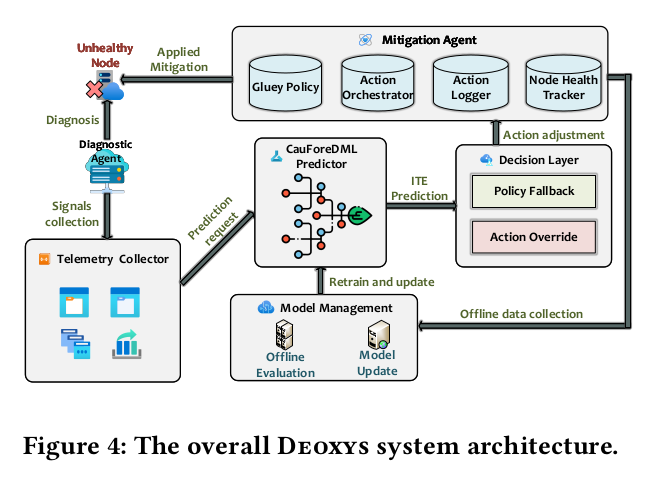
たとえば、Deoxysは観測した情報をもとにダウンタイムを最短にする操作を選択し、実行するそうです。
異常の原因を一緒に考えてくれる能力
LLMの勃興により現実的になったのが、「一緒に考える」という能力です。
機械が答えを出すのではなく、人間と機械が一緒に作業するのです。
たとえば、「機械に調査の指示を出し、調査結果をもとに人間が次の指示を考える」、という関係です。
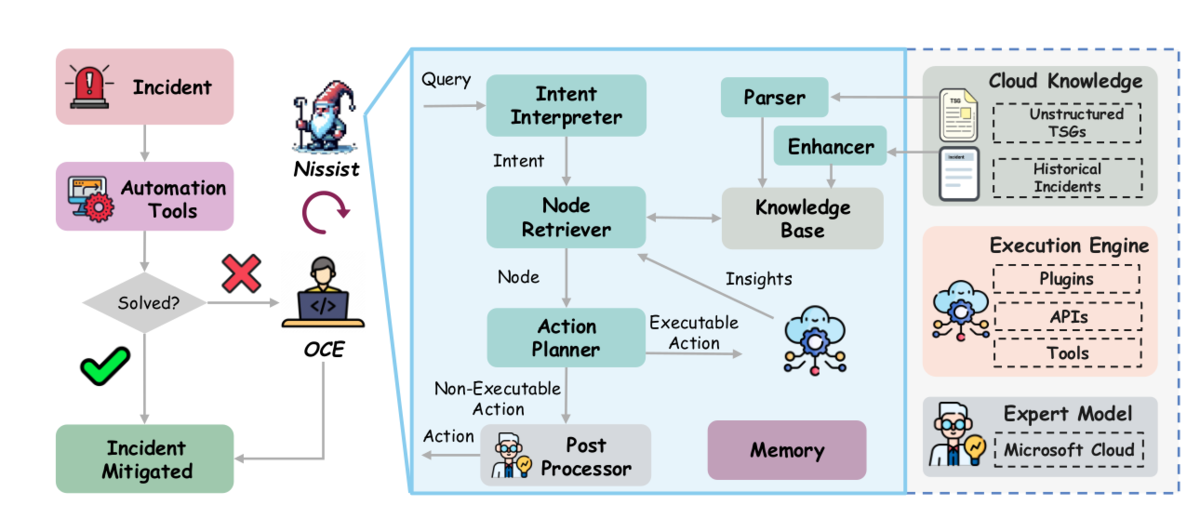
Nissistは、LLMにトラブルシューティングガイドを入力することで、オンコールエンジニアとLLMが協力できるようになっています。
オンコールエンジニアがLLMに状況を説明すると、「調査のためにこのコマンド打って」と返答し、コマンドの結果をLLMに伝えると、更に別のコマンドを考えてくれる。というループを重ねます。
会話を繰り返し、状況が改善できるまで考えてくれる、というものです。
異常を解決した後に期待する能力
異常が解決しても、終わりではありません。
再発防止を考えることが必要です。
そんなときも機械が活用できるかもしれません。
レポートを作成する能力
異常の詳細をまとめたレポートを作ってくれると助かります。
レポートを作るのは時間がかかる作業ですから、機械の手を借りたいものです。
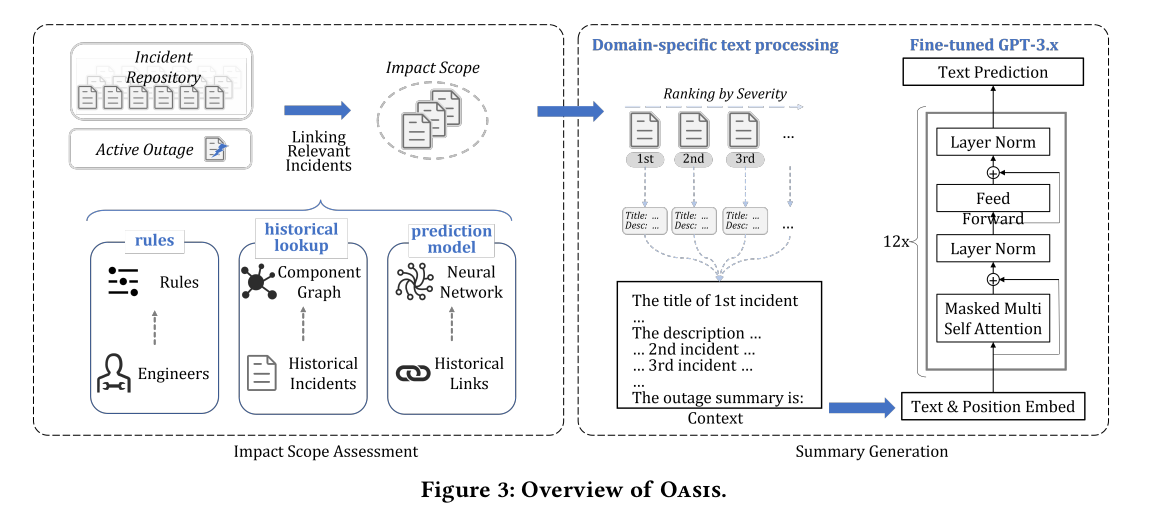
マイクロソフトは、ドメイン知識と問題把握の能力をあわせることで、インシデントのサマリーを自動で作成しているそうです。(Assess and Summarize: Improve Outage Understanding with Large Language Models)
異常を分類する能力
レポートを分類して俯瞰的な調査をすることも重要な能力です。
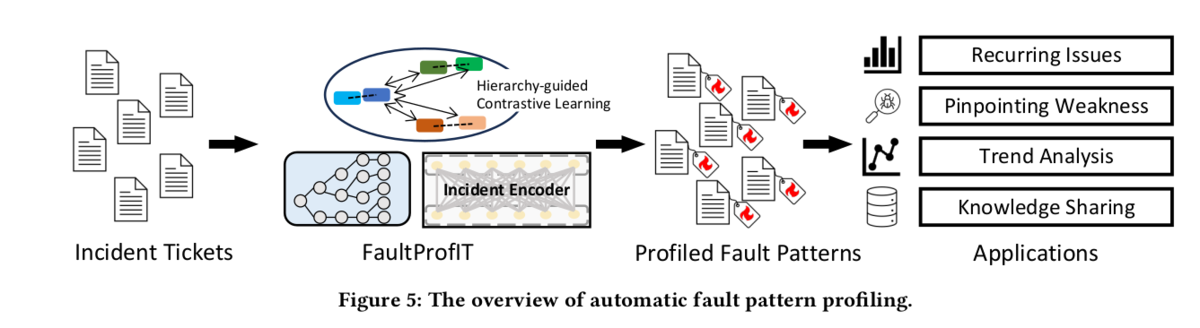
FaultProfITは大量のインシデントレポートを「物理的なインフラ」「想定外の負荷」などに分類します。
分類が自動でできると、手作業なら諦めてしまうような小さい問題まで把握できるので、発生している異常をより広く理解できるようになります。
能力を向上させるための能力
少し毛色が変わりますが、能力を向上させるための能力も重要です。
今まで挙げた能力を実現するための手段として、当然の如く機械学習が注目されています。
そして、機械学習にはデータが必要です。
しかし、学習に使えるデータは限られています。
異常はあまり起きない上、多くの場合社外秘です。
そんな状況で、社内のデータをまとめる機能や、公開データセットを充実させる能力を持つことができれば、必要な能力を更に伸ばすことが出来ます。
例えば、amazonは異常のあるデータを作っています。(The PetShop Dataset — Finding Causes of Performance Issues across Microservices)
おわりに
以上、観測したデータを利用した、より高度な機能を紹介しました。
実現に近いものから、遠いものまで、色々ありました。
そんな中からオブザーバビリティの先を感じられたら幸いです。
以上、オブザーバビリティの先の世界についての話でした。
Parquetフォーマット概観
Parquetは便利なファイル形式で、列志向のフォーマットとしてはデファクトの1つと言っても過言ではないでしょう。
ですが、jsonやcsvとは違い、ファイルを見ただけでどんな構造かわかるものではありません。
この記事は、Parquetの具体的な構造について記述します。
はじめに
この投稿は、Parquetの構造について、バイナリを見ながら確認するものです。
ただし、Parquetの大枠に注目した投稿なので、delta encodingやrun-lengthなど、個別の圧縮方法については取り扱いません。
※ Parquetの作成には https://github.com/parquet-go/parquet-go を使用していますが、goの知識は必要ありません
tldr
Parquetは以下の構造を持っています。
- ファイルはRowGroupとメタデータに分かれている
- RowGroupの中にはColumnがある
- Columnの中にはPageがある
- Pageの中にデータの本体が入っている
- Parquetはネストを全て展開して、全て別の列として扱われる (ネストや配列を入れ子にしていない)
definition levelとrepetition levelのおかげ
例えば{col1: "val1", col2: {col3: "val2"}}というデータをParquetに書くと、ファイルの構造は下のようになります。
{
  RowGroups: [
    {
      Column(for "col1"): [{
        Pages: [{
          Header(thrift形式),
          Values: [
            "val1",
            ...
          ]
        }]
      }]
    },
    {
      Column(for "col2.col3"): [{
        Pages: [{
          Header,
          Values: [
            "val2",
            ...
          ]
        }]
      }]
    }
  ],
  MetaData(thrift)
}
Parquetの特徴
Parquetは人気な形式であり、その中身に興味を持つような人はParquetの特徴をとっくに知っていることでしょう。
ここではこの投稿に必要な特徴だけ紹介します。
- 列志向である
- Dremel(Googleの社内ツール)のファイルのフォーマットを基にしている
Parquetをhexdump
まず、構造を確認するためにファイルを作成します。
jsonで表すと、下のような内容です。(見当がつきやすいようにtext列にはplainエンコーディングを使用しています)
[
  {"text": "text1"},
  {"text": "text2"},
  {"text": "text3"},
  {"text": "text4"},
  {"text": "text5"},
]
ファイル作成のためのgoコード
parquet-goを使用し、以下のようなコードからファイルを作成します。
import (
    "github.com/parquet-go/parquet-go"
)

type MyTypeSimple struct {
    Text string `parquet:"text,plain"`
}

func write1() {
    v := []MyTypeSimple{
        {Text: "text1"},
        {Text: "text2"},
        {Text: "text3"},
        {Text: "text4"},
        {Text: "text5"},
    }

    err := parquet.WriteFile("./simple.parquet", v)
    if err != nil {
        panic(err)
    }
}
ファイル(307バイト)を見ると次のようになります。
$ hexdump -C simple.parquet
00000000  50 41 52 31 15 06 15 5a  15 5a 15 ab a3 84 b4 03  |PAR1...Z.Z......|
00000010  4c 15 0a 15 00 15 0a 15  00 15 00 15 00 12 00 00  |L...............|
00000020  05 00 00 00 74 65 78 74  31 05 00 00 00 74 65 78  |....text1....tex|
00000030  74 32 05 00 00 00 74 65  78 74 33 05 00 00 00 74  |t2....text3....t|
00000040  65 78 74 34 05 00 00 00  74 65 78 74 35 19 12 00  |ext4....text5...|
00000050  19 18 05 74 65 78 74 31  19 18 05 74 65 78 74 35  |...text1...text5|
00000060  15 00 19 16 00 00 19 1c  16 08 15 92 01 16 00 00  |................|
00000070  00 15 04 19 2c 48 0c 4d  79 54 79 70 65 53 69 6d  |....,H.MyTypeSim|
00000080  70 6c 65 15 02 00 15 0c  25 00 18 04 74 65 78 74  |ple.....%...text|
00000090  25 00 4c 1c 00 00 00 16  0a 19 1c 19 1c 26 00 1c  |%.L..........&..|
000000a0  15 0c 19 15 00 19 18 04  74 65 78 74 15 00 16 0a  |........text....|
000000b0  16 92 01 16 92 01 26 08  3c 58 05 74 65 78 74 35  |......&.<X.text5|
000000c0  18 05 74 65 78 74 31 00  19 1c 15 06 15 00 15 02  |..text1.........|
000000d0  00 00 16 cc 01 15 16 16  9a 01 15 32 00 16 92 01  |...........2....|
000000e0  16 0a 19 0c 16 08 16 92  01 00 19 0c 18 37 67 69  |.............7gi|
000000f0  74 68 75 62 2e 63 6f 6d  2f 70 61 72 71 75 65 74  |thub.com/parquet|
00000100  2d 67 6f 2f 70 61 72 71  75 65 74 2d 67 6f 20 76  |-go/parquet-go v|
00000110  65 72 73 69 6f 6e 20 30  2e 32 33 2e 30 28 62 75  |ersion 0.23.0(bu|
00000120  69 6c 64 20 29 19 1c 1c  00 00 00 ba 00 00 00 50  |ild )..........P|
00000130  41 52 31                                          |AR1|
ASCIIを見ると、3行目からtext1,text2,text3...とデータが入っていることが確認できます。
このファイルを使ってParquetの中身を紐解いていきます。
※ 見やすさのため、この記事ではバイトの位置を0x00からの値で表記します。例えば、16バイト目(03)は、16(0x0f)と書きます。(0列からf列までが1行、と見る)
メタデータとファイル構造
Parquetは、公式の図にあるように、Magic Number, RowGroup, Footer, Footer length, Magic Numberで構成されています。
この章では、前章で作成したファイルのデータを基に、Parquetのデータ構造を見ていきます。
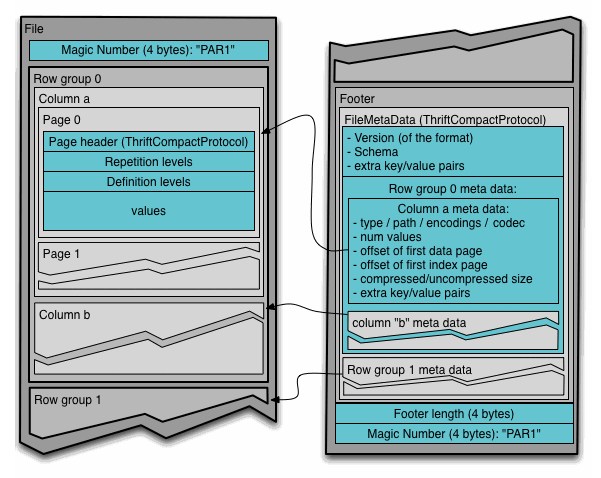
まず最初に見つかるのが、ファイルの最初と最後にあるMagic Numberです。
前章のhexdumpの結果にも最初と最後に"PAR1(50 41 52 31)"という文字が見つかります。
Footer length
さて、Parquetを読むには、まずFooterにあるファイル全体のメタデータを参照するところから始まります。
Footerの長さが最後から数えて8~4バイト目にあるので、そこからFooterの場所を計算します。(little endian)
前章のhexdumpの例では、300~303バイト目(0x12b~0x12e)にある、186(ba 00 00 00)がFooterの長さです。
Footer (FileMetaData) の取得
Footerの長さがわかったので、Footerからファイルのメタデータを抜き出します。
といっても、Footerにはメタデータしかないので、実際にはFooterをそのまま抜き出すだけでメタデータが取り出せます。
前章のhexdumpでは長さが186バイトなので、114(0x71)~299(0x12a)バイトがメタデータ部分です(15 04 19 2c ~ 1c 00 00 00部分)
ParquetのメタデータはThriftのThriftCompactProtocol形式でシリアライズされています。
parquet-formatリポジトリにある定義を基にメタデータを読むと、以下の情報が入っているとわかります。
{
  "version": 2,
  "schema": [
    { "name": "MyTypeSimple", "num_children": 1 },
    {
      "type": "BYTE_ARRAY",
      "repetition_type": "REQUIRED",
      "name": "text",
      "converted_type": "UTF8",
      "logicalType": { "STRING": {} }
    }
  ],
  "num_rows": 5,
  "row_groups": [
    {
      "columns": [
        {
          "file_offset": 0,
          "meta_data": {
            "type": "BYTE_ARRAY",
            "encodings": ["PLAIN"],
            "path_in_schema": ["text"],
            "codec": "UNCOMPRESSED",
            "num_values": 5,
            "total_uncompressed_size": 73,
            "total_compressed_size": 73,
            "data_page_offset": 4,
            "statistics": { "max_value": "text5", "min_value": "text1" },
            "encoding_stats": [
              { "page_type": "DATA_PAGE_V2", "encoding": "PLAIN", "count": 1 }
            ]
          },
          "offset_index_offset": 102,
          "offset_index_length": 11,
          "column_index_offset": 77,
          "column_index_length": 25
        }
      ],
      "total_byte_size": 73,
      "num_rows": 5,
      "file_offset": 4,
      "total_compressed_size": 73
    }
  ],
  "created_by": "github.com/parquet-go/parquet-go version 0.23.0(build )",
  "column_orders": [
    { "TYPE_ORDER": {} }
  ]
}
メタデータには色々な情報が入っていますが、本記事ではcolumnsの中の情報が重要です。
RowGroup, Column, Page内容の取得
前節でファイルのメタデータを取得できました。
更にcolumnの情報を取得します。
メタデータを見ると、row_groupsフィールドがあり、その中にcolumnsフィールドがあることがわかります。
columnsフィールドは配列です。今の例ではtext列しかないので、今回は1つです。
そのcolumnの中には最初のPageの始点(data_page_offset=4)とcolumn全体のバイト数(total_compressed_size=73)を表すフィールドがあります。
これが、text列のデータが入っている場所を示しています。
つまり、この例ではファイルの5(0x4)~77(0x4c)バイト目がcolumnの対象です。
ファイルのhexdumpを再掲します。
$ hexdump -C simple.parquet
00000000  50 41 52 31 15 06 15 5a  15 5a 15 ab a3 84 b4 03  |PAR1...Z.Z......|
00000010  4c 15 0a 15 00 15 0a 15  00 15 00 15 00 12 00 00  |L...............|
00000020  05 00 00 00 74 65 78 74  31 05 00 00 00 74 65 78  |....text1....tex|
00000030  74 32 05 00 00 00 74 65  78 74 33 05 00 00 00 74  |t2....text3....t|
00000040  65 78 74 34 05 00 00 00  74 65 78 74 35 19 12 00  |ext4....text5...|
00000050  19 18 05 74 65 78 74 31  19 18 05 74 65 78 74 35  |...text1...text5|
00000060  15 00 19 16 00 00 19 1c  16 08 15 92 01 16 00 00  |................|
00000070  00 15 04 19 2c 48 0c 4d  79 54 79 70 65 53 69 6d  |....,H.MyTypeSim|
00000080  70 6c 65 15 02 00 15 0c  25 00 18 04 74 65 78 74  |ple.....%...text|
00000090  25 00 4c 1c 00 00 00 16  0a 19 1c 19 1c 26 00 1c  |%.L..........&..|
000000a0  15 0c 19 15 00 19 18 04  74 65 78 74 15 00 16 0a  |........text....|
000000b0  16 92 01 16 92 01 26 08  3c 58 05 74 65 78 74 35  |......&.<X.text5|
000000c0  18 05 74 65 78 74 31 00  19 1c 15 06 15 00 15 02  |..text1.........|
000000d0  00 00 16 cc 01 15 16 16  9a 01 15 32 00 16 92 01  |...........2....|
000000e0  16 0a 19 0c 16 08 16 92  01 00 19 0c 18 37 67 69  |.............7gi|
000000f0  74 68 75 62 2e 63 6f 6d  2f 70 61 72 71 75 65 74  |thub.com/parquet|
00000100  2d 67 6f 2f 70 61 72 71  75 65 74 2d 67 6f 20 76  |-go/parquet-go v|
00000110  65 72 73 69 6f 6e 20 30  2e 32 33 2e 30 28 62 75  |ersion 0.23.0(bu|
00000120  69 6c 64 20 29 19 1c 1c  00 00 00 ba 00 00 00 50  |ild )..........P|
00000130  41 52 31                                          |AR1|
つまり、15 06 15 5a ~ 65 78 74 35の部分ですね。
更に、columnの最初には最初のpage用のメタデータ(Page Header)が入っています。
このメタデータもparquet-formatで定義されているthriftなので、Footerと同じようにデシリアライズすると、次のデータが取得できます。
{
  "type": "DATA_PAGE_V2",
  "uncompressed_page_size": 45,
  "compressed_page_size": 45,
  "crc": -457214166,
  "data_page_header_v2": {
    "num_values": 5,
    "num_nulls": 0,
    "num_rows": 5,
    "encoding": "PLAIN",
    "definition_levels_byte_length": 0,
    "repetition_levels_byte_length": 0,
    "is_compressed": false
  }
}
このthriftが終わるのが32(0x1f)バイト目なので、compressed_page_sizeの値(45)を考えた、33(0x20)から77(0x4c)バイト目がデータの本体だとわかります。(05 00 00 00 ~ 65 78 74 35)
データの取得
前節で33(0x20)から77(0x4c)バイトがデータの部分とわかりました。
データのバイナリは05 00 00 00 74 65 78 74 31 05 00 00 00 74 65 78 74 32...となっています。
このファイルはplainエンコーディングを使用しているので、最初に4バイトで文字長があり、その後に文字が続きます。
つまり、最初が5バイトのテキスト(74 65 78 74 31=text1)、次も5バイトのテキスト・・・と続きます。
なので、データには[text1, text2, text3, text4, text5]が入っているとわかるわけです。
ファイルには以下のデータを入れているので、データが正しく取得できたことがわかります。
[
  {"text": "text1"},
  {"text": "text2"},
  {"text": "text3"},
  {"text": "text4"},
  {"text": "text5"},
]
データにアクセスできた
これで、Parquetからデータを取り出すことができました。
Parquetには「列の値が連続で格納されている」ことと「メタデータを辿ることでデータにアクセスできる」ことがわかりました。
これで大まかな構造がわかりました。
しかし、これだけではありません。
Parquetはネストと配列がサポートされています。
ネストや配列のデータを取り出すには、更にもう1段階深堀りする必要があります。
更に先に進むため、章を分けて、もう少し続きます。
複雑なデータ構造に対応する
前章では簡単なデータ構造を持つParquetの構造を見ました。
しかし、Parquetはネストと配列を扱うことができます。
これらは、definition levelとrepetition levelという仕組みによって、通常のフィールドと同じように1列で表されています。
つまり、下のようにネストや配列があっても
{
  col1: "val1",
  col2: {col3: "val3"},
  col4: {col5: {col6: [1,2,3]}}
}
下のように同じレベルで保存されるのです。
{
  "col1": ["val1"],
  "col2.col3": ["val3"],
  "col4.col5.col6": [1,2,3]
}
この章ではdefinition levelとrepetition levelという仕組みを理解して、複雑なデータ構造を持つParquetを読み解きます。
ちなみに、この2つのレベルに関する説明はParquetのドキュメントには見つからなかったのですが、Dremelの論文をあたるとわかります
https://research.google/pubs/dremel-interactive-analysis-of-web-scale-datasets-2/
definition levelとrepetition level
まず、definition levelとrepetition levelの仕組みについて説明します。
雑に言うと、
definition levelはnullable(optional)なのにnullならなかった親フィールドの数で、
repetition levelは繰り返しがあったフィールドのレベルを表しています。
意味がわからないと思うので例をつけて解説します。
definition level
まず、definition levelについて。
次のjsonで表されるデータが入っているとします、全てのフィールドがoptional(nullable)です。
{
  nest1: {
    nest2: {
      value: "hello" // D: 3
    }
  },
},
{
  nest1: {
    nest2: {
      value: null // D: 2
    }
  },
},
{
  nest1: {
    nest2: null // D: 1
  }
},
{
  nest1: null // D: 0
},
{} // D: 0
このとき、各フィールドのdefinition levelはフィールド横のコメントの値(3,2,1,0,0)です。
definition levelを求めると、
最初の値(hello)は「nest1, nest2, valueの3フィールドがoptionalなのにnullではなかったから、definition levelは3」となります。
同様に、2つめは「nest1, nest2がoptionalなのにnullではなかったから2(valueはnullだからカウントしない)」となります。
3つ目は「nest1だけnullじゃないから1」です。
最後の2つはnest1すらnullなので0です。
このように、optionalな親フィールドの数を表すのがdefinition levelです。
この仕組みによって、対象columnだけをスキャンしてもdefinition levelをみればどこの親までnullになっているかがわかります。
repetition level
次に、repetition levelについて。
次のjsonで表されるデータが入っているとします。
{
  repeated1: [
    {
      repeated2: [
        "value1-1", // R: 0
        "value1-2", // R: 2
        "value1-3" // R: 2
      ],
      normalField2: "v1" // R: 0
    },
    {
      repeated2: [
        "value2-1", // R: 1
        "value2-2" // R: 2
      ]
      normalField2: "v2" // R: 1
    },
    {
      repeated2: [
        "value3-1", // R: 1
      ],
      normalField2: "v3" // R: 1
    }
  ],
  normalField1: "v4" // R: 0
},
このとき、repetition levelはコメントにあるRの値です。
repetition levelを求めると、
最初のvalue1-1は「それ以前に配列(repeated)のフィールドがなかったから0」です。
次のvalue1-2は「repeated2の親のrepeated1も配列であるから、repeated2のレベルは2。value1-1があるから、repeated2には繰り返しがあった。よって、value1-2のrepetition levelはrepeated2のレベルから、2」となります。
次のvalue1-3も「value1-2があるから、repeated2に繰り返しがあった。よって2」です。
対して、value2-1は「repeated2には繰り返しがないが、repeated1には繰り返しがある(value1-1などの分の要素がある)。repeated1のレベルから、1」。
更にvalue2-2は「value2-1があるから、repeated2に繰り返しがあった。よって2」。
value3-1はvalue2-1と同様に、「repeated2には繰り返しがないが、repeated1には繰り返しがある。repeated1のレベルから、1」。
と決定します。
また、自身が配列でない場合でも親に配列があれば影響されるので、
v1は「それ以前に配列(repeated)のフィールドがなかったから0」
v2とv3は「repeated1が配列として機能しているから、repeated1のレベルから、1」
v4は「親に配列がないから、0」。
と、repetition levelの値が付きます。
このように、配列として機能したフィールドのレベルを表すのがrepetition levelです。
この仕組みによって、対象columnだけをスキャンしてもrepetition levelを参照することで配列の最初かどうか、親が変わったか、などがわかります。
hexdump
これまでdefinition levelとrepetition levelについて見てきたので、ネストや配列があるファイルを読むことができるようになりました。
実際のデータをバイナリで見てみましょう。
以下のデータを使用します。
[
  {
    "nest": {
      "nest": "nest1",
      "repeated": [
        {"nest": {"repeated": ["nestRep1", "nestRep2", "nestRep3"]}},
        {"nest": {"repeated": ["nestRep4", "nestRep5"]}},
      ]
    },
  },
  {
    "nest": {
      "nest": "nest2",
      "repeated": [
        {"nest": {"repeated": ["nestRep6"]}},
      ]
    },
  },
  {
    "nest": {
      "nest": null,
      "repeated": []
    },
  },
]
このデータはparquet内では次のようなイメージで配置され、それぞれの値にdefinition levelとrepetition levelの値が振られます。
[
  {"nest.nest": [
    "nest1", // D: 2, R: 0
    "nest2", // D: 2, R: 0
    null,    // D: 1, R: 0
  ]},
  {"nest.repeated.nest.repeated": [
    "nestRep1", // D: 4, R: 0
    "nestRep2", // D: 4, R: 2
    "nestRep3", // D: 4, R: 2
    "nestRep4", // D: 4, R: 1
    "nestRep5", // D: 4, R: 2
    "nestRep6", // D: 4, R: 0
    null        // D: 1, R: 0
  ]}
]
この情報をparquetから確認します。
データをparquetにしてhexdumpで見ると、下のようになっています。
00000000  50 41 52 31 15 06 15 2c  15 2c 15 df cf fe db 0d  |PAR1...,.,......|
00000010  4c 15 06 15 02 15 06 15  00 15 08 15 00 12 00 00  |L...............|
00000020  04 02 02 01 05 00 00 00  6e 65 73 74 31 05 00 00  |........nest1...|
00000030  00 6e 65 73 74 32 15 06  15 ac 01 15 ac 01 15 bc  |.nest2..........|
00000040  81 ac e6 09 4c 15 0e 15  02 15 06 15 00 15 08 15  |....L...........|
00000050  14 12 00 00 02 00 04 02  02 01 02 02 04 00 0c 04  |................|
00000060  02 01 08 00 00 00 6e 65  73 74 52 65 70 31 08 00  |......nestRep1..|
00000070  00 00 6e 65 73 74 52 65  70 32 08 00 00 00 6e 65  |..nestRep2....ne|
00000080  73 74 52 65 70 33 08 00  00 00 6e 65 73 74 52 65  |stRep3....nestRe|
00000090  70 34 08 00 00 00 6e 65  73 74 52 65 70 35 08 00  |p4....nestRep5..|
000000a0  00 00 6e 65 73 74 52 65  70 36 19 12 00 19 18 05  |..nestRep6......|
000000b0  6e 65 73 74 31 19 18 05  6e 65 73 74 32 15 00 19  |nest1...nest2...|
000000c0  16 02 00 19 12 00 19 18  08 6e 65 73 74 52 65 70  |.........nestRep|
000000d0  31 19 18 08 6e 65 73 74  52 65 70 36 15 00 19 16  |1...nestRep6....|
000000e0  02 00 19 1c 16 08 15 64  16 00 00 00 19 1c 16 6c  |.......d.......l|
000000f0  15 e8 01 16 00 00 00 15  04 19 6c 48 06 4d 79 44  |..........lH.MyD|
00000100  65 65 70 15 02 00 35 02  18 04 6e 65 73 74 15 04  |eep...5...nest..|
00000110  00 15 0c 25 02 18 04 6e  65 73 74 25 00 4c 1c 00  |...%...nest%.L..|
00000120  00 00 35 04 18 08 72 65  70 65 61 74 65 64 15 02  |..5...repeated..|
00000130  00 35 02 18 04 6e 65 73  74 15 02 00 15 0c 25 04  |.5...nest.....%.|
00000140  18 08 72 65 70 65 61 74  65 64 25 00 4c 1c 00 00  |..repeated%.L...|
00000150  00 16 06 19 1c 19 2c 26  00 1c 15 0c 19 25 00 06  |......,&.....%..|
00000160  19 28 04 6e 65 73 74 04  6e 65 73 74 15 00 16 06  |.(.nest.nest....|
00000170  16 64 16 64 26 08 3c 36  02 28 05 6e 65 73 74 32  |.d.d&.<6.(.nest2|
00000180  18 05 6e 65 73 74 31 00  19 1c 15 06 15 00 15 02  |..nest1.........|
00000190  00 00 16 c4 03 15 14 16  d4 02 15 32 00 26 00 1c  |...........2.&..|
000001a0  15 0c 19 25 00 06 19 48  04 6e 65 73 74 08 72 65  |...%...H.nest.re|
000001b0  70 65 61 74 65 64 04 6e  65 73 74 08 72 65 70 65  |peated.nest.repe|
000001c0  61 74 65 64 15 00 16 0e  16 e8 01 16 e8 01 26 6c  |ated..........&l|
000001d0  3c 36 02 28 08 6e 65 73  74 52 65 70 36 18 08 6e  |<6.(.nestRep6..n|
000001e0  65 73 74 52 65 70 31 00  19 1c 15 06 15 00 15 02  |estRep1.........|
000001f0  00 00 16 d8 03 15 16 16  86 03 15 3e 00 16 cc 02  |...........>....|
00000200  16 06 19 0c 16 08 16 cc  02 00 19 0c 18 37 67 69  |.............7gi|
00000210  74 68 75 62 2e 63 6f 6d  2f 70 61 72 71 75 65 74  |thub.com/parquet|
00000220  2d 67 6f 2f 70 61 72 71  75 65 74 2d 67 6f 20 76  |-go/parquet-go v|
00000230  65 72 73 69 6f 6e 20 30  2e 32 33 2e 30 28 62 75  |ersion 0.23.0(bu|
00000240  69 6c 64 20 29 19 2c 1c  00 00 1c 00 00 00 57 01  |ild ).,.......W.|
00000250  00 00 50 41 52 31                                 |..PAR1|
00000256
最初に、フッターのメタデータは343(0x0157)バイトあるので、248(0xf7=598-343-8+1)バイト目から(15 04 19 6cから)始まることがわかります。
このメタデータをthriftにしてcolumnの情報に注目すると、
{
  "version": 2,
  "row_groups": [
    {
      "columns": [
        {
          "meta_data": {
            "path_in_schema": ["nest", "nest"],
            "total_compressed_size": 50,
            "data_page_offset": 4,
          },
        },
        {
          "meta_data": {
            "path_in_schema": ["nest", "repeated", "nest", "repeated"],
            "total_compressed_size": 121,
            "data_page_offset": 54,
          },
        }
      ],
    }
  ],
}
と書いてあります。
そこから更に"nest.nest"のcolumnのメタデータ(5バイト目から始まる)にあるカラムの情報を見ると、
{
  "data_page_header_v2": {
    "num_values": 3,
    "num_nulls": 1,
    "num_rows": 3,
    "encoding": "PLAIN",
    "definition_levels_byte_length": 4,
    "repetition_levels_byte_length": 0,
    "is_compressed": false
  }
}
と書かれていて、definition levelの4バイトで表され、repetition levelは書かれていない(0バイト)ことがわかります。
repetition levelが書かれていないのは、全てがゼロなので、省略されているからです。
definition levelは4バイトで、33バイト目から36バイト目(0x20~0x23)の04 02 02 01が該当箇所です。
04 02 02 01は2進数にすると00000100 00000010 00000010 00000001です。
definition levelとrepetition levelはRunLengthかBitPackingエンコーディングされています。
https://parquet.apache.org/docs/file-format/data-pages/encodings/ を見ると、データはヘッダーと値の2バイトで構成されていて、ヘッダー(前半1バイト)の8ビット目が0のときRunLengthエンコーディングされていて、1ならBitPackエンコーディングされているとわかります。
今回の例では1バイト目と3バイト目のヘッダーは両方0で終わるのでRunLengthで、ヘッダーの最後尾1ビットを除くことで0000010(0) 00000010 0000001(0) 00000001は「2(0b10)回2(0b10)の後、1(0b1)回1(0b1)」と解釈してdefinition levelは2,2,1とわかります。
次に"nest.repeated.nest.repeated"のcolumnのメタデータの情報を見ると
{
  "data_page_header_v2": {
    "num_values": 7,
    "num_nulls": 1,
    "num_rows": 3,
    "encoding": "PLAIN",
    "definition_levels_byte_length": 4,
    "repetition_levels_byte_length": 10,
    "is_compressed": false
  }
}
と書かれていて、definition levelが4バイトで、repetition levelが10バイトとわかります。
repetition levelが先に書かれるのでrepetition levelから見ると、
データは85(0x54)バイト目から始まるので、repetition levelは85(0x54)~94(0x5d)バイト目で、0000001(0) 00000000 0000010(0) 00000010 0000001(0) 00000001 0000001(0) 00000010 0000010(0) 00000000(02 00 04 02 02 01 02 02 04 00)です。
展開すると0,2,2,1,2,0,0です。
definition levelはその後の4バイトなので、95(0x5e)~98(0x61)0000110(0) 00000100 0000001(0) 00000001(0C 04 02 01)です。展開すると4,4,4,4,4,4,1とわかります。
まとめると、
- "nest.nest"の列は
definition levelが2,2,1、repetition levelが0,0,0 - "nest.repeated.nest.repeated"の列は
definition levelが4,4,4,4,4,4,1、repetition levelが0,2,2,1,2,0,0
と読むことができました。
これらの値は、はじめに出したDとRに一致しています。
[
  {"nest.nest": [
    "nest1", // D: 2, R: 0
    "nest2", // D: 2, R: 0
    null,    // D: 1, R: 0
  ]},
  {"nest.repeated.nest.repeated": [
    "nestRep1", // D: 4, R: 0
    "nestRep2", // D: 4, R: 2
    "nestRep3", // D: 4, R: 2
    "nestRep4", // D: 4, R: 1
    "nestRep5", // D: 4, R: 2
    "nestRep6", // D: 4, R: 0
    null        // D: 1, R: 0
  ]}
]
これで、ネストや配列があってもparquetを読み解けるようになりました。
最後に
これで、Paruetファイルはメタデータが含まれていて、各フィールドは全て列で表されていることがわかりました。
より詳細な話は、以下のページを参考にしてください。
https://parquet.apache.org/docs/file-format/
https://github.com/apache/parquet-format
また、ParquetはDremelの中で使われているファイルのフォーマットを参考にしていることから、公式にも「Dremelのxxxを使って・・・」という話が出てきます(特にdefinition levelとrepetition level)。その場合は、Dremelの論文を読むとわかります。
Dremel: Interactive Analysis of Web-Scale Datasets
https://research.google/pubs/dremel-a-decade-of-interactive-sql-analysis-at-web-scale/
以上、Parquetの構造の紹介でした。
